OCP(Open Compute Project)是由 Meta、Intel、Rackspace 与高盛等企业于 2011 年共同发起的开源硬体计划,旨在打破传统伺服器与资料中心硬体规格的封闭性,透过开放伺服器、储存设备、机柜设计及资料中心基础设施等技术规格,促进全球科技业者与供应链共同开发,推动硬体标准化与系统互通性。 OCP Global Summit 则是该组织每年举办的年度旗舰盛会,汇聚全球Hyperscalers、晶片大厂及硬体制造商,展示并交流 AI 伺服器、资料中心供电、液冷散热与高速网路等关键技术。2026 年 OCP Global 以「Scaling Innovation for the AI Era」为主题,随着 AI 发展逐步迈向 Agentic AI,模型不仅需要更强的运算能力,也对推论效率、记忆体容量与频宽,以及丛集内部的资料传输提出更高要求。本次展会的技术焦点在光通讯、正交背板交换器、3.5D 先进封装及记忆体等领域,反映 AI 基础设施正从单一晶片的效能竞争,转向运算、传输、记忆体与电力散热的整体系统升级。
光互连迎接 AI 算力扩张:NPO 与开放架构受关注
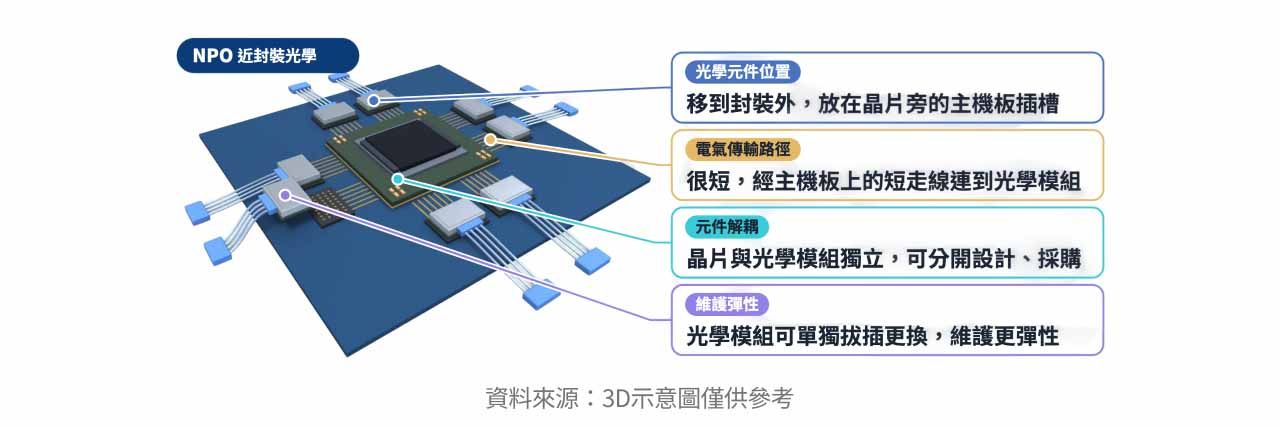
光通讯技术是本次 2026 年 OCP Global Summit 的重要主轴,反映随着 AI 模型规模、加速器数量及资料中心运算密度持续提高,系统瓶颈正逐渐延伸至资料传输与互连效率。 在峰会第二天,IPEC 举办光互连研讨会,Source Photonics、LightCounting、阿里巴巴、Meta、Oracle、微软、Ciena、Lumentum、NVIDIA 及华为等业者皆有出席。此次会议聚焦近封装光学(NPO)的技术发展与商业化前景,NPO 将光学元件配置于更靠近运算或交换晶片的位置,以缩短电气传输路径、提升频宽密度并降低功耗。相较于共同封装光学(CPO),NPO 在元件解耦与维护弹性方面具备优势。 此外,Open CPX 等开放式架构也受到关注,期望透过统一跨供应商介面,降低设备整合难度。
第三天论坛则聚焦光子技术(Photonics),NVIDIA、Meta、微软、Oracle、博通(Broadcom)、Celestica、Arista、Ciena、Amphenol、Lumentum 及华为等业者分享技术发展方向。业界普遍认为,CPO 与 NPO 将依不同应用需求并行发展,而效能、功耗、成本、部署速度及可靠性,将是评估技术导入的关键。会议中指出,约 83% 至 85% 的 CPO 故障与外部雷射光源(ELS)有关,另有约 11% 至 17% 涉及光纤或连接器问题,凸显可靠性与维护仍是技术落地的重要挑战。在系统架构方面,超过 576 颗加速器的 Scale-up 系统将朝全光学 Pod 发展,而 72 至 576 颗加速器的系统则预期由光互连与铜线互连并行支援。整体而言,光通讯已成为提升 AI 资料中心运算密度与能源效率的关键技术,长期来看,CPO 有望受惠于更高的整合度与频宽需求,但短期内 NPO 凭维护弹性与 CPO 技术难点保有发展空间,两者将依据不同应用场景与系统需求各自发展,呈现互补发展的趋势。
思科(Cisco)推出全球首个 USFP 光通讯模组
NVIDIA 与思科(Cisco)于 2026 年 OCP Global Summit 推出共同开发新一代超高密度可插拔光模组 USFP(Ultra-Dense Small Form Factor Pluggable),瞄准每通道 400Gb/s 的电气传输世代,并计划透过开放式产业规格推动多家供应商共同参与。 在架构上,现行 OSFP 等可插拔模组主要透过沿电路板边缘排列的接点与主机端连接器接合,当传输速率提高至 400G/lane,接点、连接器与走线的高频特性便成为设计挑战。USFP 改采二维阵列连接器,并设计两段式插入机制,让模组先完成定位,再接合高速接点,以改善讯号完整性并降低接点磨耗。官方资料表示,相较于每通道 200Gb/s 的可插拔光模组,USFP 预期可提升四倍频宽密度,功耗效率则提高约 1.3 倍,模组也不需要内建专属液冷回路,以保留现有可插拔架构在维修与部署上的便利性。
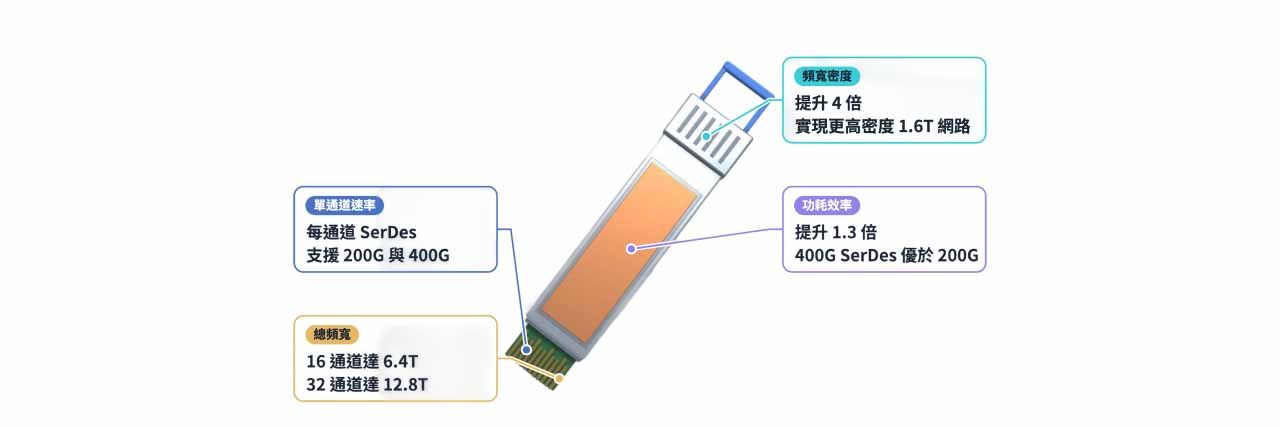
现有的方案有 OSFP 和 XPO,OSFP 优势在于产业生态成熟、供应链完整,以及客户熟悉的维修与部署流程。XPO 采用更多通道提高单一模组的总频宽,并将液冷等散热设计纳入模组架构,追求极高的前面板频宽密度,但也增加机构、散热与维护复杂度。USFP 则选择提高单通道传输速率,利用 400G/lane 在相近的模组体积内达到更高频宽,同时维持可插拔的操作模式,并避免将专属液冷回路整合进模组。换言之,XPO 着重透过增加通道数与液冷设计提升密度,USFP 则试图透过更高速的电气介面,在兼顾密度、功耗与维护便利性的前提下延续可插拔架构。 此次合作对 NVIDIA 而言,USFP 有助于整合交换器与 SuperNIC,提升 AI 网路的频宽密度,减少网路扩充层级及其电力负担,并透过开放规格扩大硬体供应来源与客户采用弹性。对 Cisco 而言,USFP 是其参与下一代高速乙太网路与光通讯规格的重要布局。透过与 NVIDIA 合作,Cisco 可结合 Silicon One 交换器晶片、网路设备与光学技术,强化整体解决方案能力;而多供应商生态系也有助于扩大产业参与,提升其在下一代 AI 网路供应链中的影响力。
整体而言,USFP 的推出反映出 AI 网路的竞争正从单纯提高光模组传输速率,进一步延伸至电气介面、连接器、散热与整体系统架构的共同设计。相较于既有 OSFP 等封装,USFP 希望以 400G/lane 提高频宽密度,同时保留可插拔模组的维修与部署优势,相较于采用更多通道及模组内液冷的 XPO,则选择以更高速的单通道设计追求密度与系统简化。
华工正源首次参加并展示 3.2T、6.4T NPO 及 12.8T XPO 解决方案
中国光通讯设备商华工科技旗下子公司华工正源,首度参加 2026 年 OCP Global Summit,展示 3.2T 高速光模组、6.4T 近封装光学(NPO)及 12.8T 超高密度可插拔光学(XPO)三大解决方案,积极布局下一代 AI 资料中心高速光互连市场。 细看产品方面,3.2T 高速光模组采用单波 400G 技术,搭载 3 奈米/2 奈米制程 DSP 晶片,单波传输速率最高可达 450Gbps,并可相容既有资料中心架构,协助客户推进网路频宽升级。6.4T NPO 则采用无 DSP 线性直驱架构,最远支援 500 公尺单模光纤传输。根据公司公布的数据,相较传统 800G OSFP 可插拔光模组,其单位面积频宽密度提升 11.4 倍,单位位元能耗降低 50%,有助于提升 AI 运算丛集的资料传输效率,同时降低高速互连的功耗负担。至于 12.8T XPO,则采用 64 通道、单波 200G 设计,模组功耗低至 130W,并可使交换器机柜密度提高 4 倍,进一步满足 AI 资料中心对高频宽、高密度及能源效率的需求。华工正源亦为 XPO MSA 标准联盟创始成员,透过参与新一代光互连规格制定,强化在高速光通讯技术与产业标准中的布局。
除高速光模组外,华工正源也持续向上游光晶片与光源技术延伸,包括自研矽光晶片、量子点光频梳外置光源(ELSFP),并建立磷化铟(InP)、砷化镓(GaAs)及矽光子(SiP)三大光电子制程平台,同时布局薄膜铌酸锂技术,以扩大高速光晶片与光源的自主研发能力,提升关键元件的供应掌握度。公司于 2026 年上半年已实现 800G、1.6T 高速光模组全球规模化交货,并持续拓展北美云端客户,显示其既有高速光通讯产品已具备一定的量产与交付基础,未来随着 AI 模型规模扩大、运算丛集持续扩张,华工正源将持续争取新一轮 AI 基础设施升级所带来的市场机会。
NVIDIA 正交背板架构升级:PTFE 高速材料与供应链布局
NVIDIA 新一代 AI 机柜架构的升级,正将高速互连与 PCB 材料推向更重要的位置。随着 Rubin Ultra 及后续 Feynman 世代朝更高 GPU 整合度与频宽发展,NVIDIA 规划的 Kyber 机柜采用运算托盘垂直插入的设计,并透过正交背板连接不同运算模组,以减少传统铜缆的使用,降低布线复杂度与空间占用,同时改善讯号完整性及散热配置。 由于背板与交换器板必须在极高传输速率下维持稳定的讯号品质,PCB 所使用的铜箔基板(CCL)材料也成为市场关注焦点。目前市场主要讨论以碳氢树脂(HC)或聚四氟乙烯(PTFE)为基础的无玻纤布 CCL。HC 方案具备材料与制程发展潜力,但在极高频应用下仍须克服介电损耗等电性要求。PTFE 则具备低介电损耗、低吸水率及良好的高频稳定性,有助于降低高速讯号传输时的衰减,而无玻纤布结构也可减少玻纤编织造成的局部介电差异与讯号传播时间差。不过,PTFE 仍面临加工难度、板材尺寸稳定性、铜箔结合、制程良率及成本等挑战。
在本次 OCP Global Summit 2026 中,NVIDIA 相关 NVLink PTFE 交换器板合作看板引起市场关注,相关供应链厂商包括 台虹 (8039.TW)、台郡 (6269.TW),以及中国的胜宏科技、深南电路、景旺电子、生益科技,和美国的 TTM Technologies。台厂部分,台虹的发展重点在于 PTFE 铜箔基板材料,透过 PTFE 搭配填料及无玻纤布设计,争取新一代高速交换器板的材料需求,若相关产品顺利通过客户验证并进入量产,将有机会提升公司在高阶高速材料市场的布局。台郡则着重于软性电路板与高速互连技术,并投入改质聚醯亚胺(PI)、液晶高分子(LCP)及 PTFE 等高阶材料应用,未来若能将材料开发与电路设计能力结合,有机会切入新一代 AI 基础设施的高阶互连方案。
整体而言,PTFE 目前仍有制程、良率与成本等技术难题,但此次于 OCP 展会中出现在 NVIDIA 相关 NVLink 交换器板的合作展示,显示其已成为新一代高速互连材料的重要发展方向。随着 AI 机柜持续朝更高频宽与更高整合度演进,PTFE 有机会成为高阶交换器板与背板的长期材料选项。对台厂的台虹以及台郡而言,关键在于 PTFE CCL 的验证与量产进度,和观察高阶材料与互连方案能否准时导入下一代平台、不会递延。
AI 基础设施新趋势:先进封装、记忆体与机柜架构
3.5D 先进封装
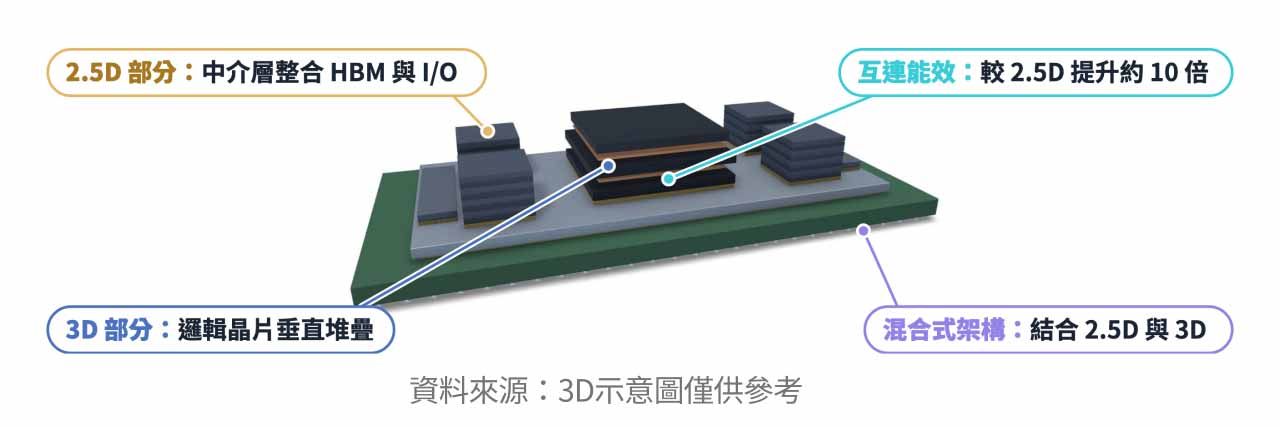
随着 2.5D 封装逐渐逼近物理极限,联发科在本次 OCP Global 中表示看好 3.5D 封装技术的发展潜力,认为其将成为延续高阶晶片运算效能的重要技术。 3.5D 属于结合 2.5D 与 3D 整合的混合式架构,透过垂直堆叠逻辑晶片,并搭配中介层整合 HBM 与 I/O 等元件,进一步提升晶片整合度与互连效率。联发科指出,其客制化 ASIC 设计可支援接近 10 倍光罩尺寸的晶片,且 3.5D 整合的晶片间互连能效较传统 2.5D 提升约 10 倍,预期未来 3 至 5 年相关应用将持续成长。此外,客制化 HBM 与专有晶片间互连的 DTCO(设计与制程协同最佳化)也将成为技术发展重点。随着 AI 晶片架构日益复杂,对于资料互联的要求越来越高,3.5D 先进封装有望迎来更多结构性成长机会。
SK 海力士发表最新记忆体架构
为解决 AI 大规模推论面临的记忆体容量与键值快取(KV-cache)瓶颈,SK 海力士高级副总裁 Kim Ho-sik 在本次 OCP Global Summit 介绍机架级记忆体系统 MARS(Memory-Centric AI Rack-Scale System),透过解耦运算与记忆体资源,建立可供多台伺服器共享的记忆体池,提升资源调度效率,降低 GPU 过度配置与整体持有成本。 此外,SK 海力士也布局高频宽快闪记忆体(HBF),以 NAND 堆叠技术提供介于 HBM 与 SSD 之间的容量与频宽选择,适用于模型权重及长上下文 KV-cache 等大型推论资料。同场发表的第二代 256GB CXL 3.2 记忆体产品,则透过记忆体池化与动态分配机制,进一步提升系统扩充弹性,产品频宽较前代提升两倍以上,能效改善约 30%。整体而言,SK 海力士并非以 HBF 取代 HBM,而是透过 HBM、HBF 与 CXL 的分层配置,分别满足高速运算、大容量储存及弹性扩充需求。随着 AI 推论与多轮对话推升记忆体需求,晶片及伺服器间的互连技术也将成为提升记忆体共享与存取效率的关键,带动 AI 记忆体架构持续演进。
Agentic AI 推升 CPU 重要性,CPU Rack 成为趋势
随着 AI 由生成式逐步走向 Agentic AI,资料中心的运算需求也正从 GPU 推论延伸至 CPU 所负责的通用运算与任务协调。AI Agent 在执行工作时,除了需要呼叫模型进行推理,也会频繁呼叫 API、查询资料库、执行程式码及操作企业系统,当代理数量与任务并行程度提高,将进一步推升 CPU 核心、记忆体与 I/O 资源需求。 AMD 执行长苏姿丰在本次展会的主题演讲中指出,代理式 AI 带动资料中心 CPU 市场快速扩张,公司已在过去九个月内三度上修市场预估,并预期未来四至五年市场年复合成长率约达 50%,2030 年规模将突破 2,000 亿美元。为因应这项趋势,AMD、Intel 与 NVIDIA 在本次 OCP Global Summit 不约而同地推出 CPU Rack 相关架构,AMD 的 Helion 采取弹性配置设计,提供最高 32,768 个 CPU 核心的纯 CPU 机柜,以及整合 EPYC CPU、Instinct GPU 与 Token Router 的全整合方案。Intel 则展示高密度 Xeon CPU 机柜,部分配置可提供超过 46,000 个 CPU 核心,并采用 OCP Open Rack v3 等开放标准,强调在特定延迟要求下提升单一机柜可同时支援的 AI Agent 数量。NVIDIA 则将 Vera CPU Rack 纳入 AI Factory 架构,透过 MGX 开放式模组化平台整合运算、网路、电力与散热,专门承担 AI Agent 的工具呼叫、工作协调及沙盒执行,并与 Vera Rubin GPU 系统分工合作。整体而言,Agentic AI 让 CPU 从传统的辅助运算角色,进一步成为需要整合成专用机柜架构,以支撑大规模代理执行的重要基础设施。
AMD Helion 机柜
AMD 董事长暨执行长苏姿丰也于本次 OCP Global 以「打造下一个 AI 基础建设时代」为题发表主题演讲,聚焦机柜级 AI 系统的发展与开放式架构的产业意义。其中,由AMD 主导设计的 Helios 机柜采用 OCP 宽版开放机柜标准,与 Meta 共同设计、可整合 72 颗 GPU 协同运作,并已于 2026 年 9 月开始量产出货。此外,AMD 也推出面向代理式 AI(Agentic AI)的 Helion 机柜,整合 CPU、GPU、液冷与 Token 路由器,预计于 11 月起供应,并将相关规格开放予 OCP 社群。 搭配预计于 2027 年上半年量产的第六代 EPYC Verano 处理器,AMD 正逐步完善从晶片到机柜的 AI 基础设施布局。对市场而言,Helios 的意义不仅在于提供 NVIDIA 以外的高效能 AI 系统选择,更在于透过开放式规格与标准化设计,降低客户对单一供应商软硬体生态系的依赖,提升系统整合与供应链选择的弹性。值得注意的是,Helion 的 13 家合作伙伴中有 8 家台湾企业,包含 鸿海 (2317.TW)、云达(广达旗下)、纬颖 (6669.TW)(纬创旗下)、神达 (3706.TW)、英业达 (2356.TW)、华硕 (2357.TW)、华擎 (3515.TW)、技嘉 (2376.TW),为台厂提供新的成长机会。
总结:AI 基础设施竞争从晶片效能走向高速传输与系统整合
整体而言,2026 年 OCP Global Summit 反映 AI 基础设施的竞争正从单一晶片的运算效能,进一步延伸至高速传输能力。随着 GPU 数量、模型规模与 Agentic AI 工作负载持续增加,运算节点之间的资料交换量快速攀升,传输频宽、延迟与能耗逐渐成为影响整体运算效率的关键。从 USFP、NPO、CPO 等光通讯技术,到正交背板、3.5D 先进封装及新一代记忆体互连架构,皆显示产业正积极突破传统电气介面与互连架构的限制,提升频宽密度、降低传输功耗,避免资料传输成为 AI 算力扩张的瓶颈。未来,随着 AI 丛集持续扩大,高速传输不仅是连接运算晶片的基础,更将成为决定大规模 AI 系统效能与扩充能力的重要环节。2026 年 OCP Global Summit 的机柜展示,也凸显 AI 基础设施正朝向系统性整合发展。光宝科 (2301.TW)、台达电 (2308.TW) 及 康舒 (6282.TW) 等电源厂展示 800VDC、±400V 等高压直流供电方案,纬创 (3231.TW)、纬颖 (6669.TW) 与 华硕 (2357.TW) 则推出搭载 NVIDIA Vera Rubin 或 AMD Helios 平台的机柜解决方案,整合运算、供电与液冷散热。整体而言,未来 AI 基础设施的竞争将不再局限于晶片效能,而是延伸至供电、散热、传输与运算的协同设计及整体整合能力。
