NVIDIA Vera Rubin NVL72 为承接 Grace Blackwell 世代的机柜级 AI 运算系统,主要应用于大型模型训练、推论及代理式 AI。其中,Vera 为 NVIDIA 自研的 Arm 架构 CPU,Rubin 为新一代 GPU,NVL72 则代表单一 NVLink 高速互连网域内整合 72 颗 GPU。其核心设计在于协同最佳化 GPU、CPU、记忆体、网路、供电与散热,使整座机柜形成紧密协作的运算系统,降低大型模型运算过程中跨处理器资料传输、同步及等待所耗费的时间。
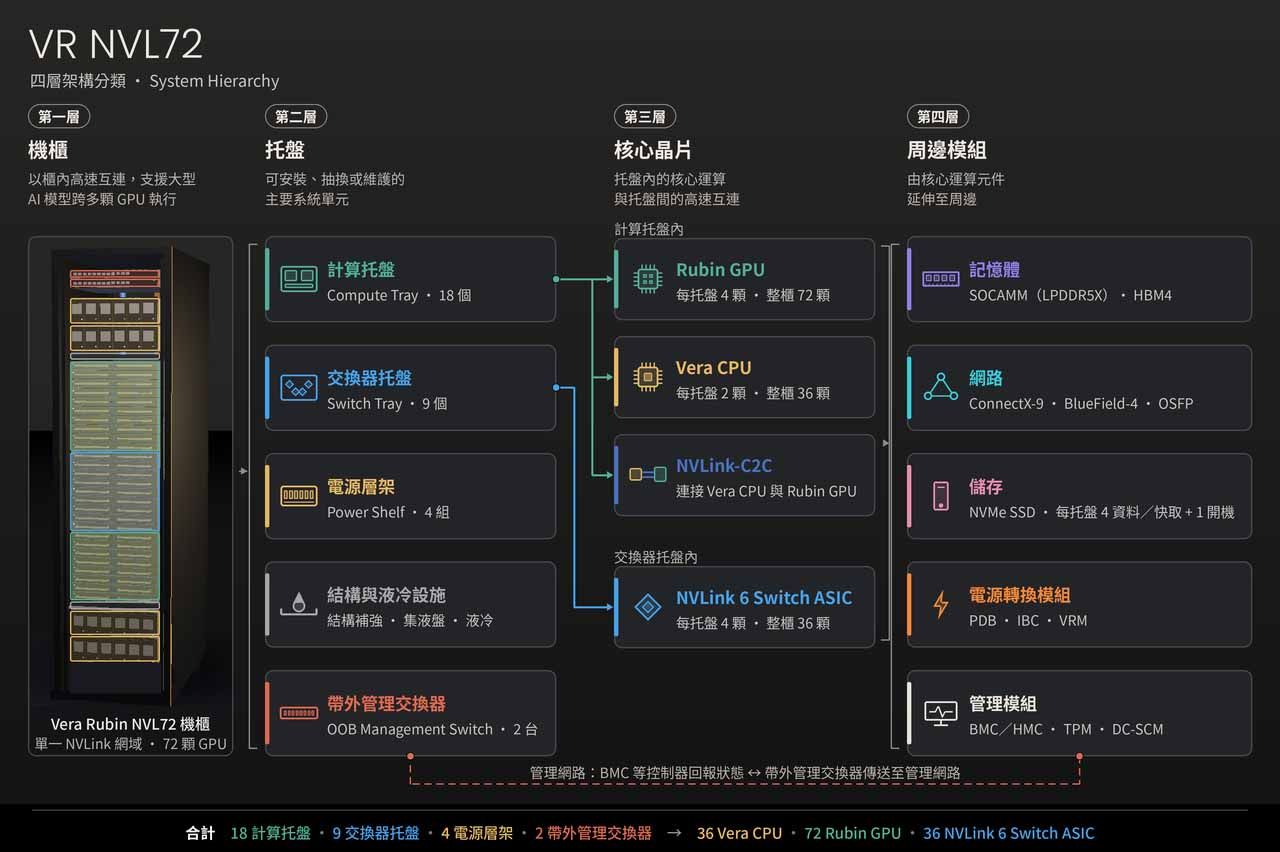
本文聚焦于 Vera Rubin NVL72 计算机柜;完整的 Vera Rubin 平台则进一步涵盖外部网路、储存及其他专用运算机柜。本文将机柜结构拆解成四层,由大到细,一一讲解其组成与功能。
- 机柜为 Vera Rubin NVL72 的第一层架构,主要透过柜内高速互连,支援大型 AI 模型跨多颗 GPU 执行,将模型权重、运算工作与中间结果分配至不同 GPU 协同处理。
- 第二层架构涵盖计算托盘、交换器托盘、电源层架、带外管理交换器,以及结构与液冷设施,构成机柜内可安装、抽换或维护的主要系统单元。
- 第三层架构涵盖 Vera CPU、Rubin GPU、NVLink-C2C 与 NVLink 6 Switch ASIC,负责托盘内的核心运算及托盘间的高速互连。
- 第四层架构由核心运算元件延伸至周边,涵盖记忆体、网路、储存、电源转换与管理模组。
Vera Rubin 机柜透过高速互连实现跨单元协同运算
机柜为 Vera Rubin NVL72 的第一层架构,主要透过柜内高速互连,支援大型 AI 模型跨多颗 GPU 执行,将模型权重、运算工作与中间结果分配至不同 GPU 协同处理。
Vera Rubin NVL72 采用 48U MGX 机柜架构,依图示配置,18 个 1U 计算托盘分布于机柜中段的上下两区,中央配置 9 个 1U NVLink 交换器托盘,并整合 4 组 3U 电源层架、顶部 2 台带外管理交换器,以及结构补强、集液与液冷系统。每个计算托盘搭载 2 组 Vera Rubin Superchip,每组由 1 颗 Vera CPU 与 2 颗 Rubin GPU 透过 NVLink-C2C 高速互连,因此单一托盘包含 2 颗 CPU 与 4 颗 GPU,整柜合计配置 36 组 Superchip、36 颗 CPU 及 72 颗 GPU。Superchip 代表 CPU 与 GPU 紧密互连的整合运算单元,并非单一裸晶;每颗 Rubin GPU 封装内另含 2 颗主要运算裸晶,因此整柜共对应 144 颗主要 GPU 运算裸晶。中央的交换器托盘各搭载 4 颗 NVLink 6 Switch ASIC,整柜合计配置 36 颗交换晶片,构成连接 72 颗 GPU 的高速互连网域。计算托盘内另整合 CPU 使用的 LPDDR5X 记忆体、GPU 使用的 HBM4 记忆体、ConnectX-9 网路晶片、BlueField-4 DPU、NVMe SSD,以及电源转换与管理模组;机柜背面则配置 NVLink 铜缆背板、供电汇流排、液冷歧管与接头,透过运算、互连、供电及散热的协同设计,支援整柜高密度运算与日常维护需求。
Vera Rubin 机柜内含计算托盘、交换器托盘、电源层架等架构
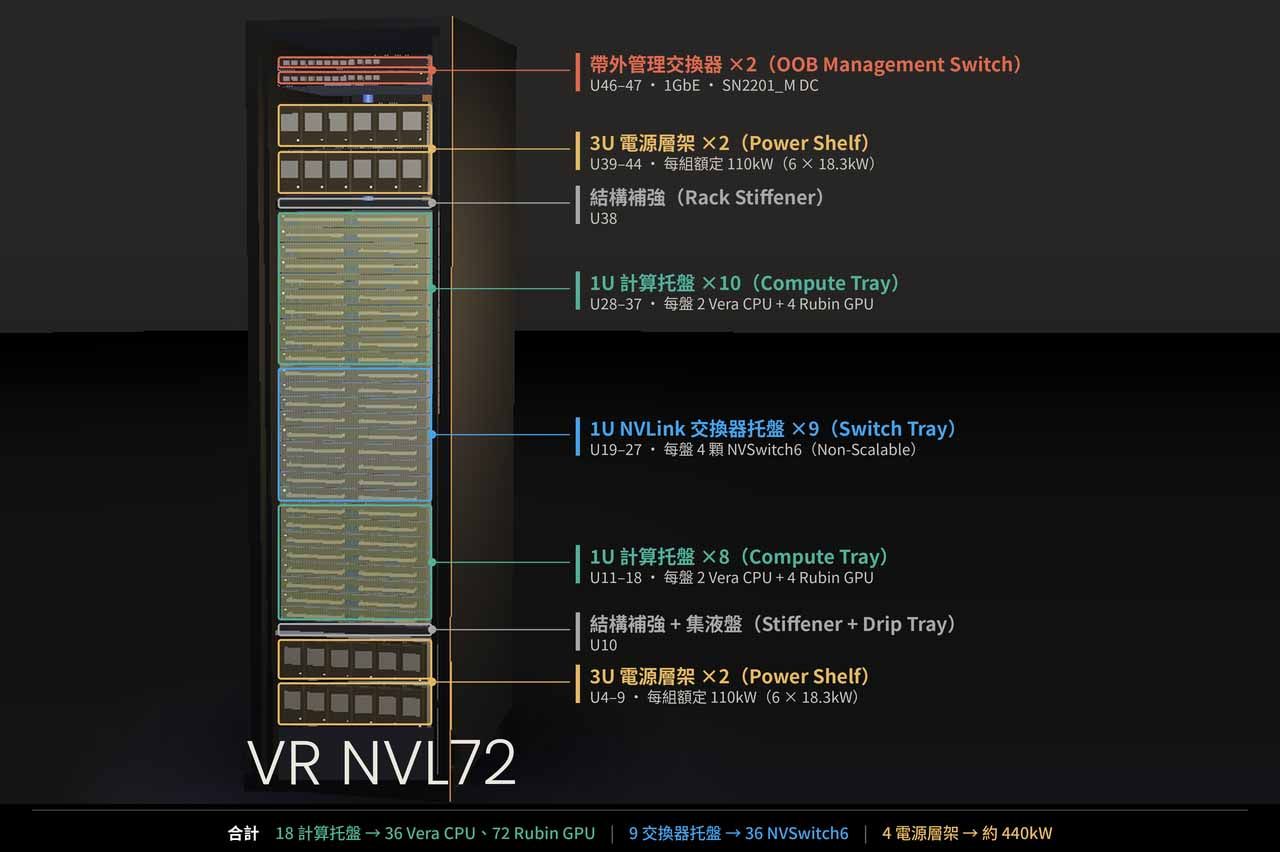
第二层架构涵盖计算托盘、交换器托盘、电源层架、带外管理交换器,以及结构与液冷设施,构成机柜内可安装、抽换或维护的主要系统单元。(上述为参考架构;不同 OEM 的实际配置仍可能调整)
| 第二层单元 | 每柜配置 | 主要工作 |
|---|---|---|
| 计算托盘 (Compute Tray) | 18 个,每个 1U | 容纳 CPU、GPU、记忆体、网路及储存模组,执行运算 |
| NVLink 交换器托盘 (Switch Tray) | 9 个,每个 1U | 串接全柜计算托盘的 GPU,组成单一 NVLink 网域 |
| 电源层架 (Power Shelf) | 4 组,每组 3U、额定 110 kW | 将外部电力转换为机柜使用的直流电 |
| 带外管理交换器 (OOB Management Switch) | 2 台 | 传送硬体监控、韧体与远端管理讯息 |
| 结构补强、集液与液冷系统 | 分布于机柜及托盘内 | 支撑与定位零组件、分配冷却液、带走热量 |
计算托盘 (Compute Tray) 整合双 Superchip,透过模组化设计串联运算与周边系统
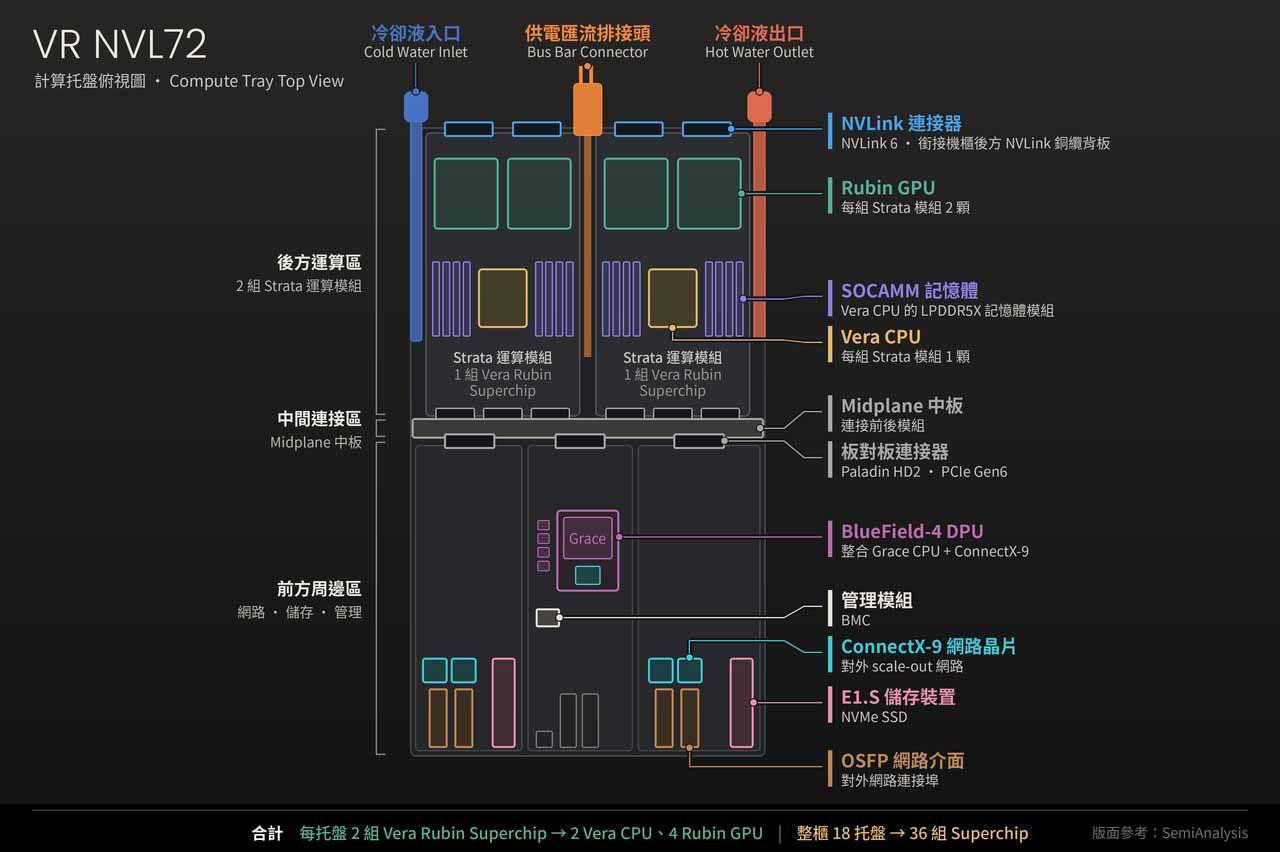
计算托盘为承载 Vera Rubin NVL72 主要运算元件的系统单元,每个托盘配置 2 颗 Vera CPU 与 4 颗 Rubin GPU,依图示可分为后方运算区、中间连接区及前方周边区。后方由两组 Strata 运算模组构成,每组搭载 1 颗 Vera CPU、2 颗 Rubin GPU 及相关记忆体,并透过尾端的 NVLink 连接器与供电汇流排接头,衔接机柜内的高速互连与供电系统;中间配置 Midplane 中板,连接前后模组;前方则整合 ConnectX-9 网路晶片、OSFP 网路介面、E1.S 储存装置及管理模组,托盘两侧另设有冷却液入口与出口,支援液冷散热。每组由 1 颗 Vera CPU 与 2 颗 Rubin GPU 组成的运算单元称为 Vera Rubin Superchip,因此单一托盘包含 2 组 Superchip,整柜 18 个计算托盘合计搭载 36 组;Superchip 代表 CPU 与 GPU 紧密互连的整合运算单元,并非将三颗处理器合并为单一裸晶。 整体采模组化插接设计,透过中板与板对板连接器,减少托盘内需逐条安装的线缆,提升组装与维修便利性;机柜后方的 NVLink 铜缆背板及对外网路连线则仍为系统互连的重要组成。
交换器托盘 (Switch Tray) 整合 NVLink 6 交换晶片,支援 72 颗 GPU 高速互连
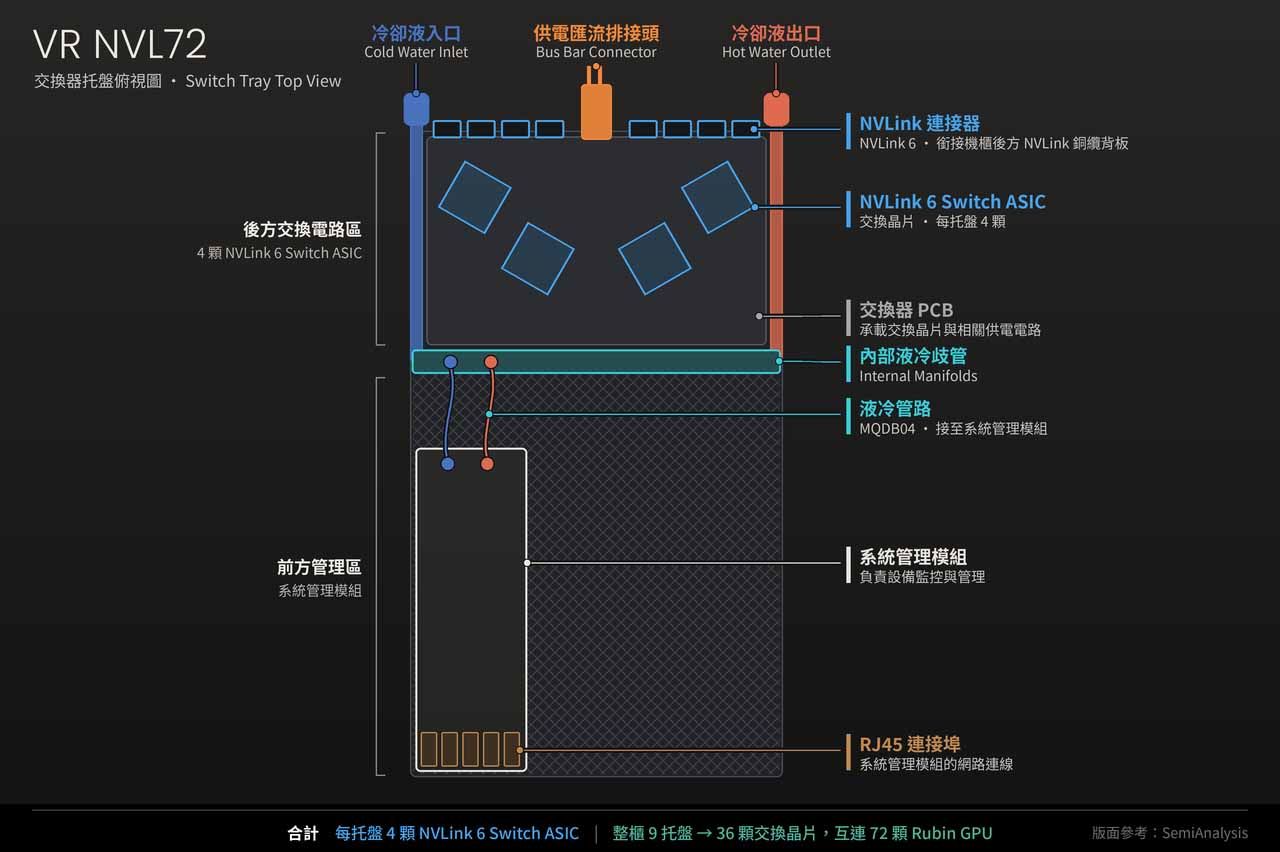
交换器托盘为 Vera Rubin NVL72 机柜内负责 GPU 间资料交换的系统单元,每个托盘搭载 4 颗 NVLink 6 Switch ASIC,整柜 9 个托盘合计配置 36 颗交换晶片。依图示,托盘后方为主要交换电路区,配置交换晶片、交换器 PCB 及相关供电电路,尾端设有 NVLink 连接器与供电汇流排接头,分别衔接机柜后方的 NVLink 铜缆背板与供电系统;两侧配置冷却液入口及出口,并透过内部液冷歧管、管路与冷板带走元件运作产生的热量,前方则设有系统管理模组,负责设备监控与管理。计算托盘内的 GPU 透过铜缆背板连接至交换晶片,由各交换器托盘共同构成涵盖 72 颗 GPU 的 NVLink 高速互连网域,支援不同计算托盘之间交换模型资料与运算结果。其中,交换器托盘是整合交换、供电、管理及散热元件的可安装与维护设备,交换晶片则是托盘内实际执行资料交换的 ASIC,两者分属系统设备与核心元件的不同层级。
电源层架 (Power Shelf) 将交流电转为 54V 直流电,透过汇流排供应各托盘用电
电源层架负责机柜层级的电力转换,依现行 DGX 文件,每组额定容量为 110 kW,内含 6 个约 18.3 kW 的 PSU,将 415–480V AC 转换为 54V DC,再透过机柜供电汇流排配送至各托盘。整柜配置 4 组电源层架,合计 24 个 PSU,额定容量共 440 kW。此数值代表电源设备的总容量,实际耗电仍取决于工作负载、功率设定及其他元件负载,可用供电能力亦须考量备援配置。电力进入托盘后,再由电源转换模组进一步降压至各晶片所需的工作电压。
带外管理交换器 (OOB Management Switch) 串联硬体管理介面,支援独立监控与远端维护
带外管理交换器负责串联机柜内各装置的硬体管理介面,透过独立的管理路径,支援远端开关机、温度与电压监控、韧体更新及故障纪录读取等功能。只要管理控制器与管理网路维持供电且正常运作,即使主机作业系统无回应,管理人员仍可透过此路径检查设备状态,并视情况执行重启。机柜顶端的两台带外管理交换器,连接计算托盘、BlueField-4 及交换器托盘的管理控制器,主要承载设备监控与维护所需的管理讯息;大量 AI 运算资料则透过 NVLink 或 ConnectX-9 所连接的运算网路传输。因此,带外管理交换器与 GPU 使用的高速交换网路,在设备功能与传输内容上具有明确区别。
散热架构涵盖机柜、托盘与晶片三层级,涵盖液冷与气冷设计
Vera Rubin NVL72 的散热系统可由大至小分为机柜、托盘及晶片与元件三个层级。
- 第一层为机柜级,涵盖供液与回液歧管、管路及快速接头,负责将冷却液分配至各托盘,并将吸收的热量带往机柜外的冷却液分配单元 CDU,另包含供电汇流排的液冷与电源供应器的风扇气冷。
- 第二层为托盘级,涵盖计算托盘与交换器托盘内的分流管路、接头及整合式冷板模组,将冷却液导向 CPU、GPU、记忆体、网路晶片与交换器晶片等发热区域。
- 第三层为晶片与元件级,涵盖晶片散热上盖、导热介面材料 TIM、冷板接触面及内部流道,透过导热与热交换将晶片产生的热量传递至冷却液;采气冷的元件则经由导热材料与散热片,将热量传递至气流并带离元件。
| 层级 | 主要散热零组件 | 功能与涵盖范围 |
|---|---|---|
| 第一层:机柜级 | 供液与回液歧管、管路、快速接头、汇流排液冷结构、电源供应器风扇 | 分配与回收各托盘的冷却液,将热量送往机柜外的 CDU;同时涵盖供电汇流排的液冷与电源供应器的气冷。 |
| 第二层:托盘级 | 托盘内部分流管路、接头、整合式冷板模组 | 在计算托盘与交换器托盘内,将冷却液导向 CPU、GPU、记忆体、网路晶片、交换器晶片及供电元件等发热区域。 |
| 第三层:晶片与元件级 | 晶片散热上盖、导热介面材料(TIM)、冷板接触面与内部流道、散热片 | 将晶片与元件的热量传入冷板,再由冷却液带走;采气冷的元件则透过导热材料与散热片,将热量交由气流带走。 |
Vera Rubin 第三层架构整合核心运算与高速互连,支援托盘内外协同运作
第三层架构涵盖 Vera CPU、Rubin GPU、NVLink-C2C 与 NVLink 6 Switch ASIC,负责托盘内的核心运算及托盘间的高速互连。 其中,Vera CPU 与 Rubin GPU 配置于计算托盘,NVLink-C2C 为连接 CPU 与 GPU 的介面及通讯协定;NVLink 6 Switch ASIC 则配置于交换器托盘,支援不同计算托盘内 GPU 之间的资料交换。
Vera CPU 承担系统控制与资料处理,支援 CPU 与 GPU 协同运算
Vera CPU 配置于计算托盘,负责系统控制、资料处理及各类 CPU 工作负载,每个托盘搭载 2 颗,整柜共 36 颗。 每颗 Vera 配备 88 个 NVIDIA 自研 Olympus 核心,支援 176 个硬体执行绪,整柜合计提供 3,168 个核心与 6,336 个执行绪。在 AI 系统中,Vera 主要承担资料前处理、控制程式执行、工作排程及 I/O 处理,并协调 CPU 与 GPU 之间的资料交换。随着代理式 AI 与强化学习应用发展,程式编译、工具呼叫、环境模拟及结果验证等任务亦增加 CPU 处理需求;若这些环节形成瓶颈,即使 GPU 仍有可用算力,也可能因等待资料或控制流程而闲置,因此 CPU 处理能力与互连效率同样影响整体系统的运算利用率。
Rubin GPU 采双裸晶设计,支援大规模平行运算与 AI 矩阵加速
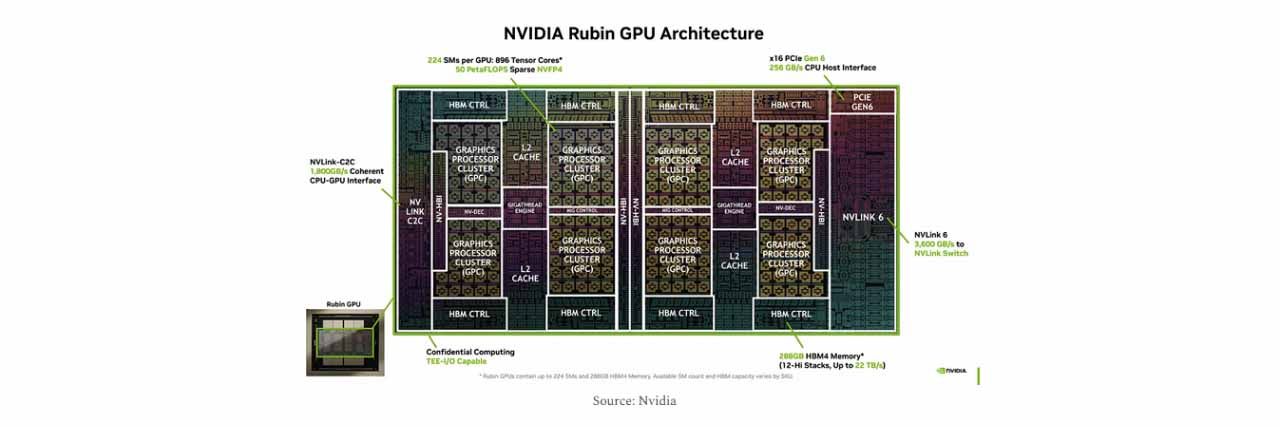
Rubin GPU 同样配置于计算托盘,负责大量平行运算与 AI 矩阵运算,每组 Vera Rubin Superchip 搭载 2 颗,每个计算托盘配置 4 颗,整柜合计 72 颗。 单颗 Rubin GPU 采双运算裸晶封装设计,透过 NV-HBI 高速互连,整合约 3,360 亿个电晶体,最高配置 224 个串流多处理器 SM 与 896 个 Tensor Core。效能方面,单颗 Rubin GPU 的 NVFP4 密集运算峰值为 35 PFLOPS,稀疏推论运算峰值为 50 PFLOPS。实际运算效能除取决于峰值算力,亦受到记忆体资料供应速度及跨 GPU 通讯效率影响,两者共同决定 GPU 能否持续维持高运算利用率。
NVLink-C2C 串联 CPU 与 GPU,NVLink 6 支援跨 GPU 资料交换
NVLink-C2C 与 NVLink 6 Switch ASIC 分别负责 CPU 与 GPU 之间的一致性互连,以及 GPU 之间的资料交换。NVLink-C2C 连接 Vera CPU 与 Rubin GPU,由处理器上的介面电路、实体连线及通讯协定共同构成,属于高速互连介面。官方于 Vera Rubin Superchip 层级列出的 NVLink-C2C 频宽为 1.8 TB/s,除支援高速资料传输外,亦提供一致性记忆体存取,让 CPU 与 GPU 协同使用记忆体,降低资料交换与同步的管理负担,串联资料处理、控制流程及 GPU 运算。
NVLink 6 Switch ASIC 则配置于交换器托盘,每个托盘搭载 4 颗,整柜合计配置 36 颗。当模型分散于多颗 GPU 执行时,这些交换晶片负责将资料传送至目的 GPU,支援模型平行、专家路由、梯度交换及集合通讯。
| 互连 | 连接对象 | 在系统中的作用 |
|---|---|---|
| NVLink-C2C | Vera CPU ↔ Rubin GPU | CPU 与 GPU 协作、资料交换及一致性记忆体存取 |
| NVLink 6 | Rubin GPU ↔ NVLink Switch ↔ 其他 Rubin GPU | 建立整柜 72 颗 GPU 的高速互连网路 |
Vera Rubin 第四层架构涵盖记忆体、网路、电源转换与管理等模组
第四层架构由核心运算元件延伸至周边,涵盖记忆体、网路、储存、电源转换与管理模组。 其中,HBM4 整合于 GPU 封装内,LPDDR5X 配置于 CPU 旁的记忆体模组,其余元件则主要分布于托盘内的板卡及周边模组。
| 元件 | 实际所在位置 | 参考配置下的数量 |
|---|---|---|
| Vera 使用的 LPDDR5X | Strata 板上的 SOCAMM 模组 | 每 CPU 8 个模组,整柜 288 个 |
| Rubin 使用的 HBM4 | GPU 封装内 | 每 GPU 8 个堆叠,整柜 576 个 |
| 主机 NVMe SSD | 计算托盘的资料/快取与开机槽位 | 每托盘 4+1 个,整柜 90 个槽位 |
| 独立 ConnectX-9 | 计算托盘前方网路模组 | 每托盘 8 颗,整柜 144 颗 |
| BlueField-4 DPU | 计算托盘前方 DPU 模组 | 每托盘 1 组,整柜 18 组 |
| 电源转换模组 | 电源配送板及各功能板卡 | 包含 PDB、IBC、VRM,依板卡配置 |
| 管理模组 | 计算、交换器及其他装置模组 | 分散配置 BMC/HMC、管理与安全元件 |
LPDDR5X 与 HBM4 分别支援 CPU 容量需求与 GPU 高频宽存取
LPDDR5X 与 HBM4 分别为 Vera CPU 与 Rubin GPU 使用的记忆体,两者在配置、容量、频宽及维修方式上各有差异。LPDDR5X 为记忆体技术规格,SOCAMM 则是承载记忆体的可拆换模组形式,两者属于不同分类。 依附件配置,每颗 Vera CPU 搭配 8 个 SOCAMM,分布于 CPU 两侧,用于存放执行中的程式、工作资料与运作状态,亦可透过 CPU 与 GPU 互连,支援需要较大记忆体容量的工作负载。每颗 Vera 的记忆体容量最高约 1.5 TB、频宽最高约 1.2 TB/s,整柜 CPU 记忆体容量最高约 54 TB;可拆换模组设计则有助于缩小记忆体故障时的维修更换范围。
HBM4 为整合于 Rubin GPU 封装内、邻近运算裸晶的高频宽记忆体,透过记忆体堆叠与宽介面提供高速资料传输,主要存放模型权重、运算中间结果及推论使用的 KV cache。依附件配置,每颗 Rubin 搭载 8 个 HBM 堆叠,单颗 GPU 记忆体容量为 288 GB、频宽为 19.2 TB/s,整柜容量约 20.7 TB。其中,容量决定可容纳的模型与工作资料规模,频宽则决定资料供应至 GPU 的速度;当 GPU 反复读取模型权重与 KV cache 时,HBM 的资料供应能力将直接影响运算单元的等待时间与利用率。由于 HBM 属于 GPU 封装的一部分,其维修与更换方式亦不同于可拆换的 SOCAMM。
NVMe SSD 提供托盘内持久储存
NVMe SSD 提供计算托盘内的非挥发性储存,其中 NVMe 为储存通讯协定,E1.S 则为 SSD 的外形规格。依现行配置,每个计算托盘设有 4 个资料/快取 SSD 槽位及 1 个主机开机 SSD 槽位,整柜分别为 72 个与 18 个,合计 90 个主机 SSD 槽位。开机 SSD 用于存放作业系统与相关软体,资料/快取 SSD 则支援本地资料暂存、模型载入及快取。相较于 HBM 与 LPDDR5X,SSD 可提供较大容量的持久储存空间,但存取延迟较高、频宽较低,因此 SSD、CPU 记忆体与 GPU 记忆体各自承担不同层级的资料储存与存取需求,并由软体协调资料在各层之间的移动。
电源转换模组满足晶片低电压、大电流需求
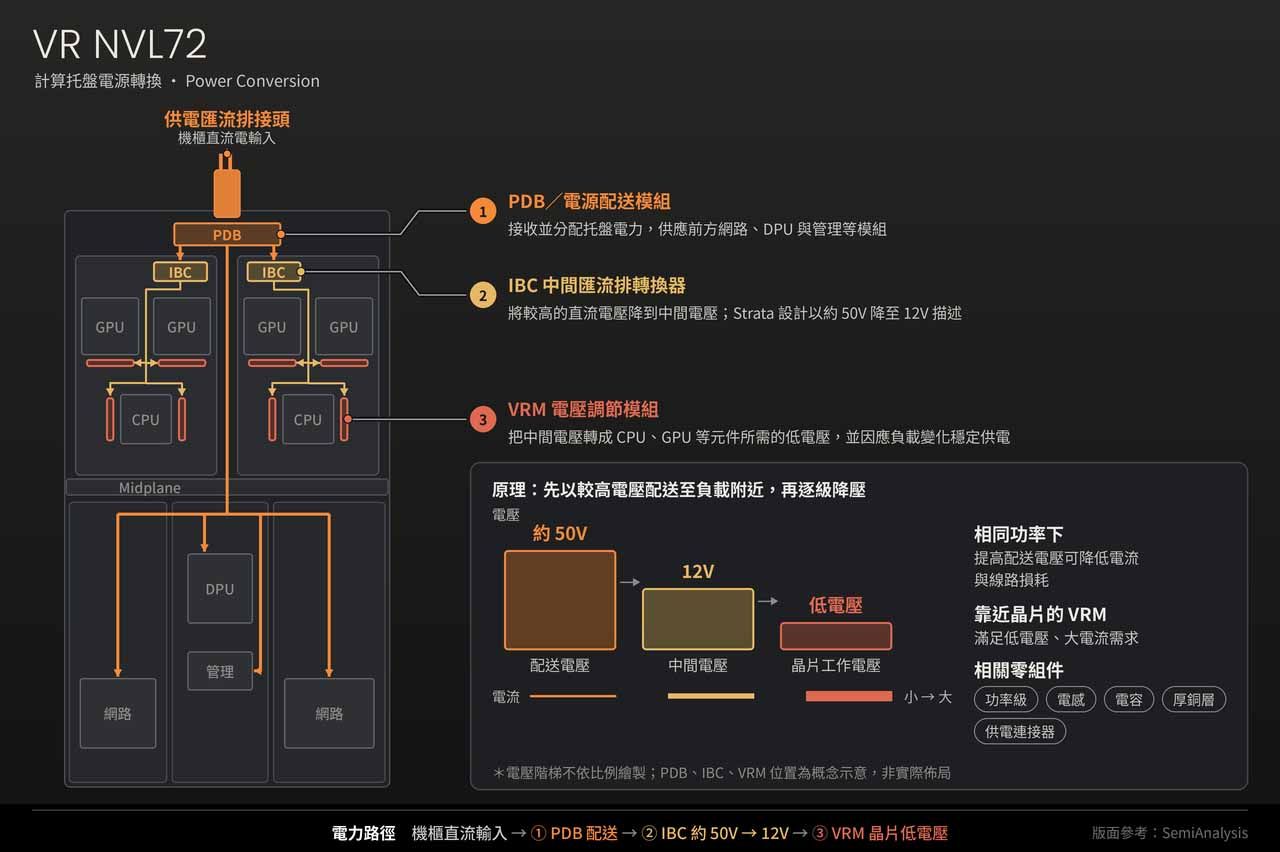
电源转换模组负责将机柜输入的直流电转换为各晶片所需的工作电压,主要涵盖电源配送、中间电压转换及末端稳压三项功能:
- PDB/电源配送模组: 接收并分配托盘电力,供应前方网路、DPU 与管理等模组。
- IBC,中间汇流排转换器: 将较高的直流电压降到中间电压;附件的 Strata 设计以约 50V 降至 12V 描述。
- VRM,电压调节模组: 再把中间电压转成 CPU、GPU 或其他元件所需的低电压,并因应负载变化稳定供电。
原理为先以较高电压将电力配送至接近负载的位置,再逐级降压;在相同功率下,提高配送电压可降低电流与线路损耗,靠近晶片的 VRM 则负责满足低电压、大电流的供电需求。相关零组件包括功率级、电感、电容、厚铜层及供电连接器,共同支撑电力转换与配送。
管理模组透过带外网路支援设备维护
管理模组负责监测硬体状态、执行控制及建立安全信任机制。计算托盘透过 BMC/HMC 等控制器进行硬体监控、保存事件纪录,并提供远端管理介面。其中,BMC 着重硬体监控与控制,TPM 提供安全金钥保护、完整性量测及信任功能,DC-SCM 则将部分管理与安全控制功能整合为模组。交换器托盘亦配置自身的管理与安全元件,因此整柜管理系统由分布于各托盘的控制器与模组共同构成。
此层架构与带外管理交换器直接衔接:BMC 等控制器负责取得设备状态及执行管理命令,带外管理交换器则负责将相关讯息传送至管理网路。例如,当托盘侦测到温度异常时,管理控制器会记录事件并回报,供管理系统进一步诊断及安排维护。
结论
透过机柜、托盘、核心晶片与周边模组的逐层拆解,可看出 NVIDIA Vera Rubin NVL72 以整柜协同运作为设计核心。计算托盘整合 CPU、GPU 与记忆体,交换器托盘建立跨 GPU 的高速通讯网路,供电与散热系统支撑高密度负载下的持续运算,管理模组则提供硬体监控、故障诊断与远端维护功能。各层元件透过资料传输、电力配送、冷却循环及管理网路紧密连结,将个别元件的功能整合为完整的机柜级 AI 运算能力。
